GeForce RTX 3090 Ti y RTX 4090 experimentan un salto brutal en rendimiento de inteligencia artificial gracias a un nuevo método de desbloqueo en Linux que elimina las restricciones artificiales impuestas por el fabricante.
RTX 3090 Ti y RTX 4090: Desbloquean toda su potencia de IA en Linux
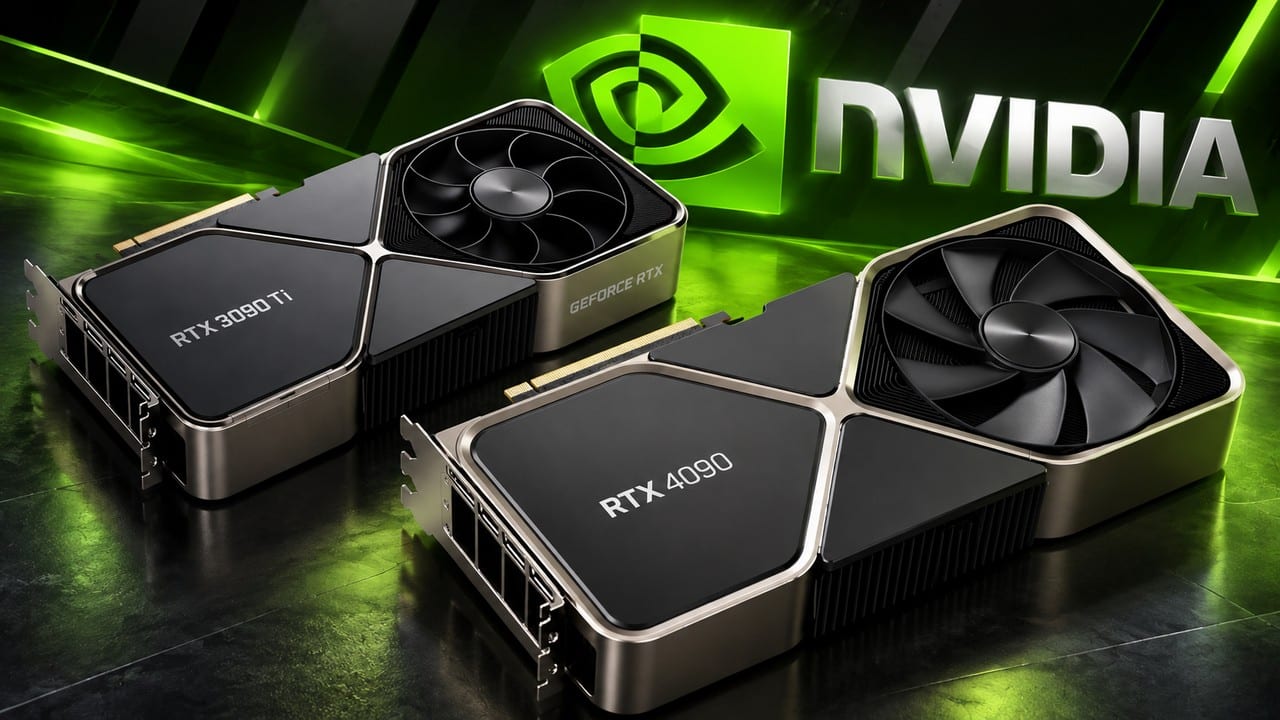
Si andas metido en el mundo del hardware y el entrenamiento de modelos, seguro sabrás que Nvidia suele limitar por software las capacidades de cálculo de sus tarjetas gráficas de consumo para obligarte a pagar por modelos profesionales de la línea workstation. Un desarrollador acaba de cambiar este panorama con un proyecto de código abierto conocido como GPU Unlock. Esta herramienta parchea el módulo del kernel de Linux y engaña al controlador del sistema para que reconozca una GPU GeForce común como si fuera una gráfica profesional de gama alta.
El truco intercepta la identificación del dispositivo por el bus PCIe justo antes de que cargue el driver oficial. Este cambio sobrevive sin problemas a los reinicios de las líneas PCIe y supera las pruebas estándar de CUDA, mostrando una estabilidad muy sólida.
Mejoras de rendimiento con GPU Unlock
| Modelo de Tarjeta | Operación / Formato | Rendimiento Base | Rendimiento Desbloqueado |
| GeForce RTX 3090 Ti | Cómputo BF16 | 87.5 TFLOPS | 157.0 TFLOPS |
| GeForce RTX 3090 Ti | Cómputo TF32 | 42.6 TFLOPS | 82.6 TFLOPS |
| GeForce RTX 4090 | FP16 con acumulación | 165.6 TFLOPS | 331.6 TFLOPS |
| GeForce RTX 4070 Ti SUPER | Tasa de emisión FP16 | 95.0 TFLOPS | 189.9 TFLOPS |
Now 🤯 an insane JAILBREAK for RTX 4000 series,
NVIDIA really tightened things down with blackwell 🙁Git Repo link : https://t.co/TTBQ8Xmvv2 https://t.co/SDiKXsUjhR pic.twitter.com/GFfZmbvfbV
— Stable Diffusion Tutorials (@SD_Tutorial) October 24, 2026
Estos números significan que una RTX 3090 Ti logra exprimir casi un 80% más de potencia bruta en tareas de inteligencia artificial. Del mismo modo, las tarjetas de la serie 40 como la RTX 4090 duplican por completo sus cifras en operaciones de precisión mixta manteniendo el mismo consumo eléctrico. Además, las pruebas en motores de inferencia como vLLM demuestran aceleraciones de hasta un 36% en el procesamiento de contextos largos, recortando los tiempos de espera iniciales.
Por el momento, esta modificación funciona únicamente bajo sistemas operativos Linux y abarca desde las generaciones pasadas hasta la familia RTX 30. Aunque las arquitecturas más recientes llegan con medidas de seguridad diseñadas para bloquear este tipo de parches, la comunidad demuestra que todavía hay un margen enorme para exprimir el hardware sin gastar de más. Seguramente, ya se este trabajando en alguna versión para sistemas operativos Windows. Os mantendremos al tanto de todas las novedades.