Los datos suelen ir cifrados cuando se guardan o cuando viajan por la red, pero hay que descifrarlos en memoria para poder procesarlos. La nueva TPU 8tx de Google cierra ese hueco, ya que mantiene protegidos los datos y los pesos del modelo, es decir, los parámetros que ha aprendido, incluso mientras están en uso. Es uno de los dos sistemas que la compañía acaba de sumar a la octava generación de sus aceleradores para IA.
Google aclara que no son chips nuevos, sino sistemas. Es decir, reutiliza el silicio de las TPU 8t y 8i y cambia lo que las rodea: encapsulado, memoria, red y seguridad. Así puede lanzar configuraciones especializadas en meses en lugar de años.
Dos sistemas para dos problemas distintos
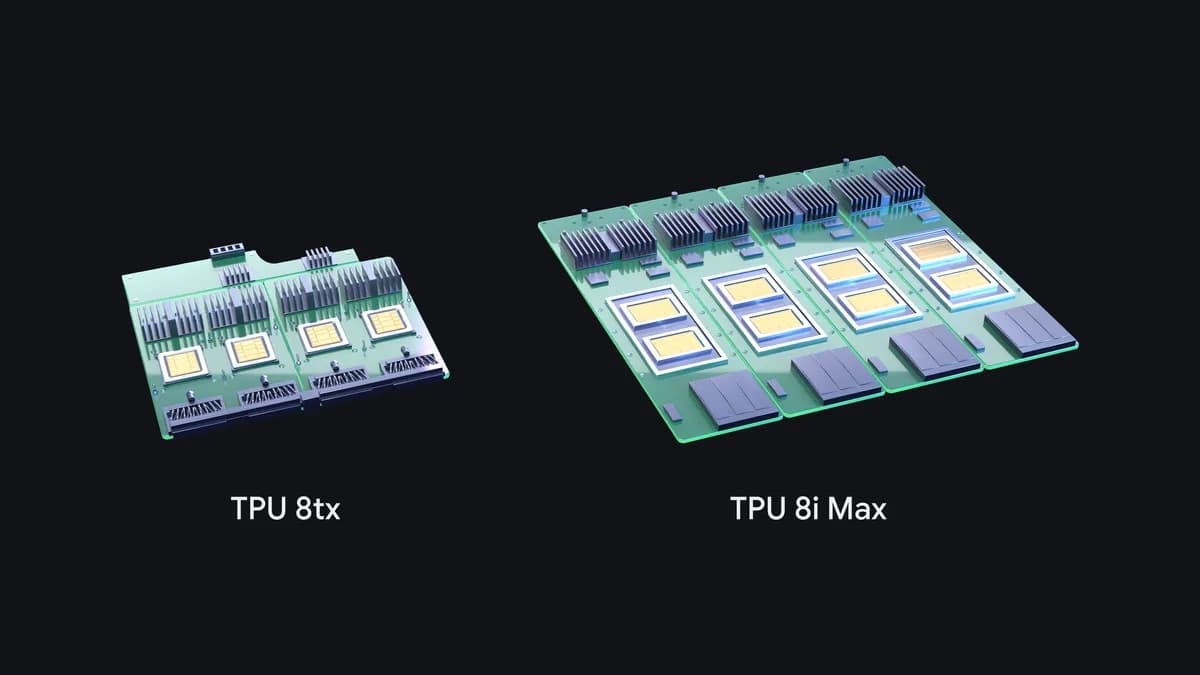
La TPU 8tx comparte silicio con la TPU 8t y trabaja junto a procesadores AMD EPYC de quinta generación. Está dirigida a empresas reguladas y gobiernos con datos sensibles. Gracias a la red Boardfly, reduce hasta a la mitad la latencia de la TPU 8t. Además, permite ajustar modelos con datos privados o entrenar agentes en el mismo sistema, sin mover la información entre clústeres.
La TPU 8i Max, por su parte, ataca el cuello de botella de la memoria. Une dos chips TPU 8i en un solo encapsulado y duplica el cómputo, la SRAM y el ancho de banda de la memoria HBM. Como ocupa el mismo espacio en el rack, los centros de datos ganan potencia por metro cuadrado y por vatio. Su terreno son los contextos de millones de tokens, como decenas de agentes trabajando sobre un código completo.
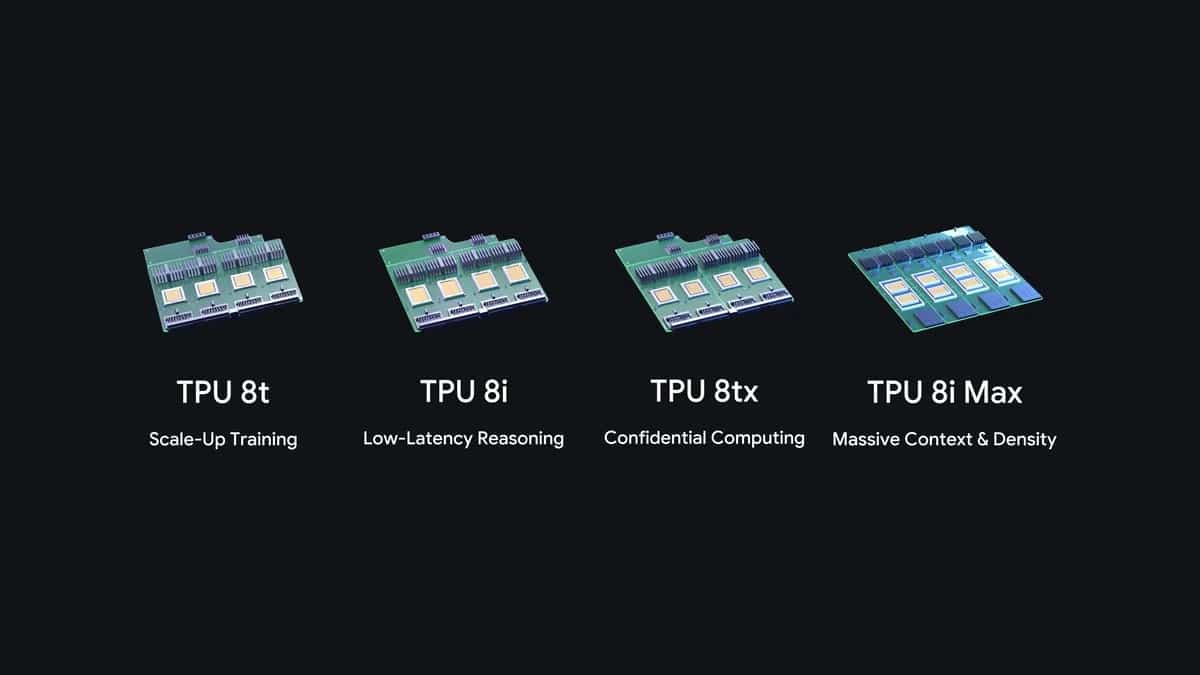
Con la llegada de estos nuevos TPU de Google, la familia queda así:
- TPU 8t para entrenamiento.
- TPU 8i para razonamiento con baja latencia.
- TPU 8tx para computación confidencial.
- TPU 8i Max para contextos enormes.
Por cierto, el lanzamiento llega acompañado de novedades de software. TorchTPU, liberado el mes pasado, ejecuta código de PyTorch y modelos de Hugging Face en TPU sin reescribirlos.
Google también libera TPU Sync, que recorta más de un 90 % la latencia de la caché KV y el tiempo hasta el primer token. En paralelo, GKE dynamic slicing ya está disponible y acelera hasta cinco veces el arranque de tareas.
Te interesa 👉 Las mejores tarjetas gráficas que puedes comprar
Por último, Google ofrece en versión preliminar un conjunto de agentes para configurar las TPU con lenguaje natural. Se integra con herramientas como Claude Code, Cursor o Google Antigravity.